


Je profite de la sortie de ma vidéo avec Micode/Underscore pour écrire un article en français sur un sujet assez particulier: les bots.
C’est un sujet de niche, souvent traité dans des articles techniques et majoritairement en anglais. C’est aussi un sujet que je connais bien, donc j’ai tendance à trouver ça assez “normal”. Mais dès que j’en parle autour de moi, les gens sont souvent surpris d’apprendre que:
- la plupart des sites web sont en permanence sous attaque par des bots
- certains produits (comme des sneakers ou des tickets de concerts) sont achetés en quelques secondes par des bots
- ou encore qu’il existe des millions d’adresses IP utilisées comme proxies pour masquer du trafic automatisé
Dit autrement: une partie significative du trafic sur internet n’est pas humaine.
Et pourtant, en tant qu’utilisateur, tout ça reste largement invisible. On navigue, on clique, on crée des comptes, sans forcément se rendre compte de ce qui se passe en arrière-plan.
Ce décalage est important, parce qu’il explique aussi beaucoup de choses du côté des sites.
Par exemple, les protections qui peuvent sembler frustrantes au quotidien:
- CAPTCHA
- files d’attente virtuelles
- vérifications par SMS
- demandes de confirmation supplémentaires
Ces mécanismes dégradent clairement l’expérience utilisateur, et les sites en sont parfaitement conscients.
Mais dans beaucoup de cas, ils ne sont pas là par confort. Sans ces protections, certaines plateformes ne pourraient tout simplement pas fonctionner face au volume de fraude.
L’objectif de cet article n’est pas de rentrer dans tous les détails techniques, ni de faire un guide exhaustif. Il y aurait largement de quoi écrire plusieurs articles pour ça.
L’idée est plutôt de poser les bases, de manière simple, pour:
- expliquer ce qu’est un bot, concrètement
- montrer à quoi ils servent (et pas uniquement pour attaquer)
- donner une intuition de comment les sites essaient de les détecter
- et surtout, expliquer pourquoi le problème est plus difficile qu’il n’en a l’air
Si à la fin de l’article les CAPTCHA, les files d’attente ou les protections anti-bot sont perçus un peu différemment, alors l’objectif est rempli.
Qu’est-ce qu’un bot?
Un bot (ou robot informatique) est simplement un programme informatique qui automatise des actions sur internet. Dit comme ça, ça peut paraître un peu abstrait, mais en pratique c’est assez simple: au lieu qu’un humain clique, tape au clavier et navigue sur un site, c’est du code qui le fait à sa place.
Et surtout, il peut le faire:
- beaucoup plus vite
- en continu (24h/24)
- et à très grande échelle
C’est cette combinaison qui change tout !
Un humain peut effectuer quelques actions par minute. Un bot peut en effectuer des milliers, voire beaucoup plus, sans pause. C’est précisément ce passage à l’échelle qui rend les bots intéressants… et problématiques.
Des bots utiles
Tous les bots ne sont pas mauvais, loin de là. Un exemple très concret: Googlebot.
C’est le bot de Google qui parcourt le web pour indexer les pages. Sans ce type de bot, les moteurs de recherche ne pourraient pas fonctionner correctement.
On retrouve aussi des bots dans des usages plus “internes”:
- tester automatiquement un site (tests automatisés)
- surveiller qu’un service fonctionne correctement (monitoring)
- automatiser des tâches répétitives
Dans ces cas-là, les bots permettent surtout de gagner du temps et de fiabiliser certaines opérations.
Des bots malveillants
Le problème apparaît quand cette capacité d’automatisation est utilisée pour abuser des systèmes.
Par exemple:
- credential stuffing: tester automatiquement des millions de couples email/mot de passe (souvent issus de fuites) sur différents sites
- création de faux comptes: pour spammer, diffuser des arnaques ou manipuler des systèmes (avis, likes, etc.)
- fraude au paiement: tester automatiquement des cartes bancaires volées pour identifier celles qui fonctionnent
Ce qui rend ces attaques efficaces, ce n’est pas forcément leur complexité technique: c’est le volume.
Un humain ne peut pas tester 100 000 mots de passe. Un bot, lui, peut le faire très rapidement, et même répéter l’opération sur des dizaines de sites.
Des usages dans une zone grise
Entre les deux, il existe des usages plus ambigus.
Par exemple:
- scraping: récupérer automatiquement des données d’un site (par exemple toutes les annonces d’un site immobilier)
- scalping: acheter automatiquement des produits en édition limitée (sneakers, billets de concert…) pour les revendre plus chers
Dans ces cas-là, ce n’est pas forcément illégal dans tous les contextes, mais l’impact est bien réel.
Typiquement:
- des produits deviennent indisponibles en quelques secondes
- les utilisateurs “classiques” (humains) n’ont même pas le temps d’acheter
- certains marchés deviennent dominés par des acteurs automatisés
Ce qui est intéressant, c’est que techniquement, tous ces cas reposent sur la même base: automatiser des actions humaines.
C’est ensuite l’usage et l’échelle qui font toute la différence.
À quoi ressemble un bot en pratique?
Quand on parle de bots, on peut vite imaginer quelque chose de complexe ou “high-tech”, qui fonctionne à base d’intelligence artificielle.
En réalité … c’est juste du code.
Un bot, c’est simplement un programme informatique (un logiciel) qui va reproduire ce qu’un humain ferait sur un site:
- ouvrir une page
- cliquer sur des boutons
- remplir des formulaires
- naviguer entre différentes pages
Sauf qu’il le fait automatiquement.
Et surtout, il peut répéter ces actions:
- beaucoup plus vite
- sans interruption
- et à très grande échelle
Un exemple simple
Prenons un exemple concret avec https://pptr.dev/ (Puppeteer), une librairie développée par Google qui permet de contrôler Chrome avec du code.
const puppeteer = require('puppeteer');

(async () => {
    const browser = await puppeteer.launch();
    const page = await browser.newPage();
    await page.goto('https://antoinevastel.com/');

    // Get the list of article titles
    const titleArticles = await page.$$eval('article a', aElts => {
        return aElts.map(aElt => aElt.text)
    })

    console.log(titleArticles)
    // [
    //     "Analyzing Recent's Magento 1 Credit Card Skimmer",
    //     'Creating a simple ExpressJS middleware to detect bots',
    //     'Bot detection 101: How to detect web bots?',
    //     'Bot detection 101: Categories of web bots',
    //     'Benchmarking our JavaScript obfuscator',
    //     'Improving our homemade JavaScript obfuscator',
    //     'A simple homemade JavaScript obfuscator',
    //     'The Intriguing Sneaker Bot industry',
    //     'Detecting Chrome headless, the game goes on!',
    //     'Automatically beautify JavaScript files on the fly with Puppeteer and Chrome headless'
    //   ]
    await browser.close()
})()
Ce script:
- lance un navigateur
- va sur un site (mon site)
- récupère les titres des articles
C’est exactement ce que ferait un humain… sauf que là c’est automatisé. Et surtout, ce type de script peut être exécuté:
- des centaines de fois en parallèle
- sur des milliers de pages
- sans aucune fatigue
C’est là que l’échelle devient intéressante, et problématique quand c’est utilisé à des fins malveillantes.
Des bots sans code
Un point souvent sous-estimé: aujourd’hui, il n’est même plus nécessaire de savoir programmer pour utiliser des bots.
Il existe des outils avec interface graphique.
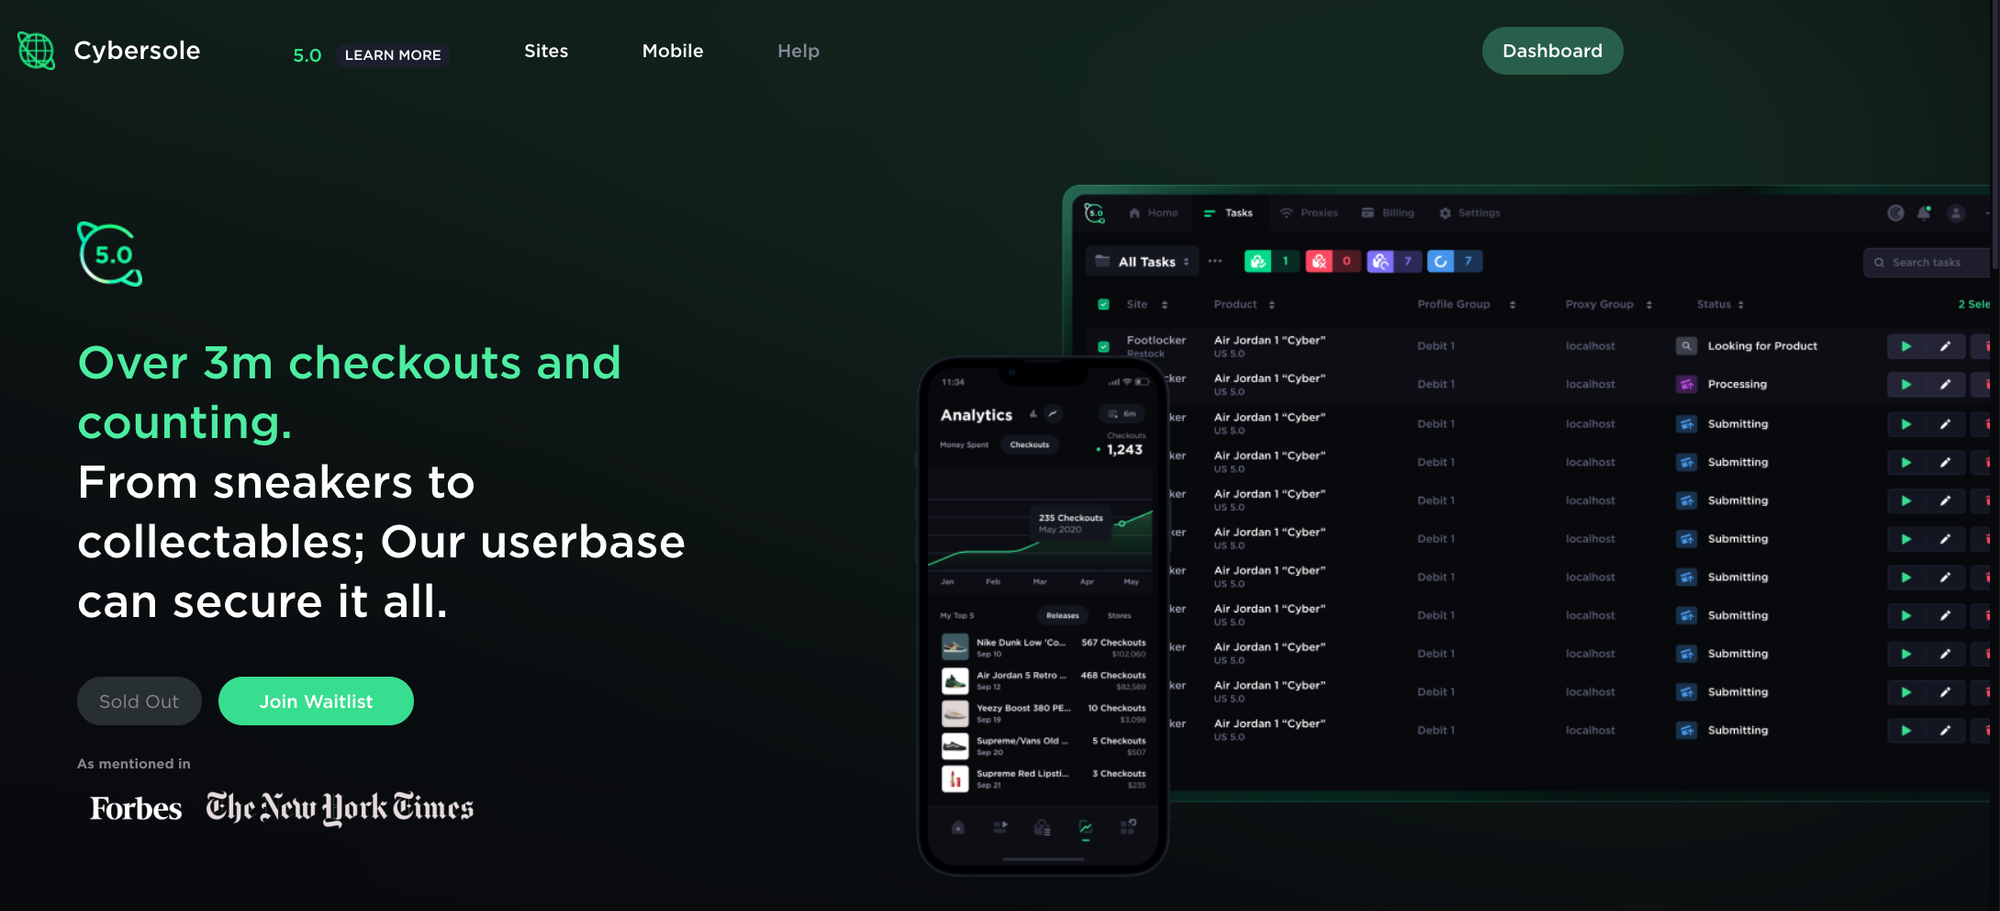
Par exemple, Cybersole permet d’acheter automatiquement des produits en édition limitée. L’utilisateur configure quelques paramètres (site, produit, taille, etc.), et le bot s’occupe du reste.
Des outils plus avancés
Pour des usages plus offensifs, comme le vol de comptes, on trouve des outils comme OpenBullet.
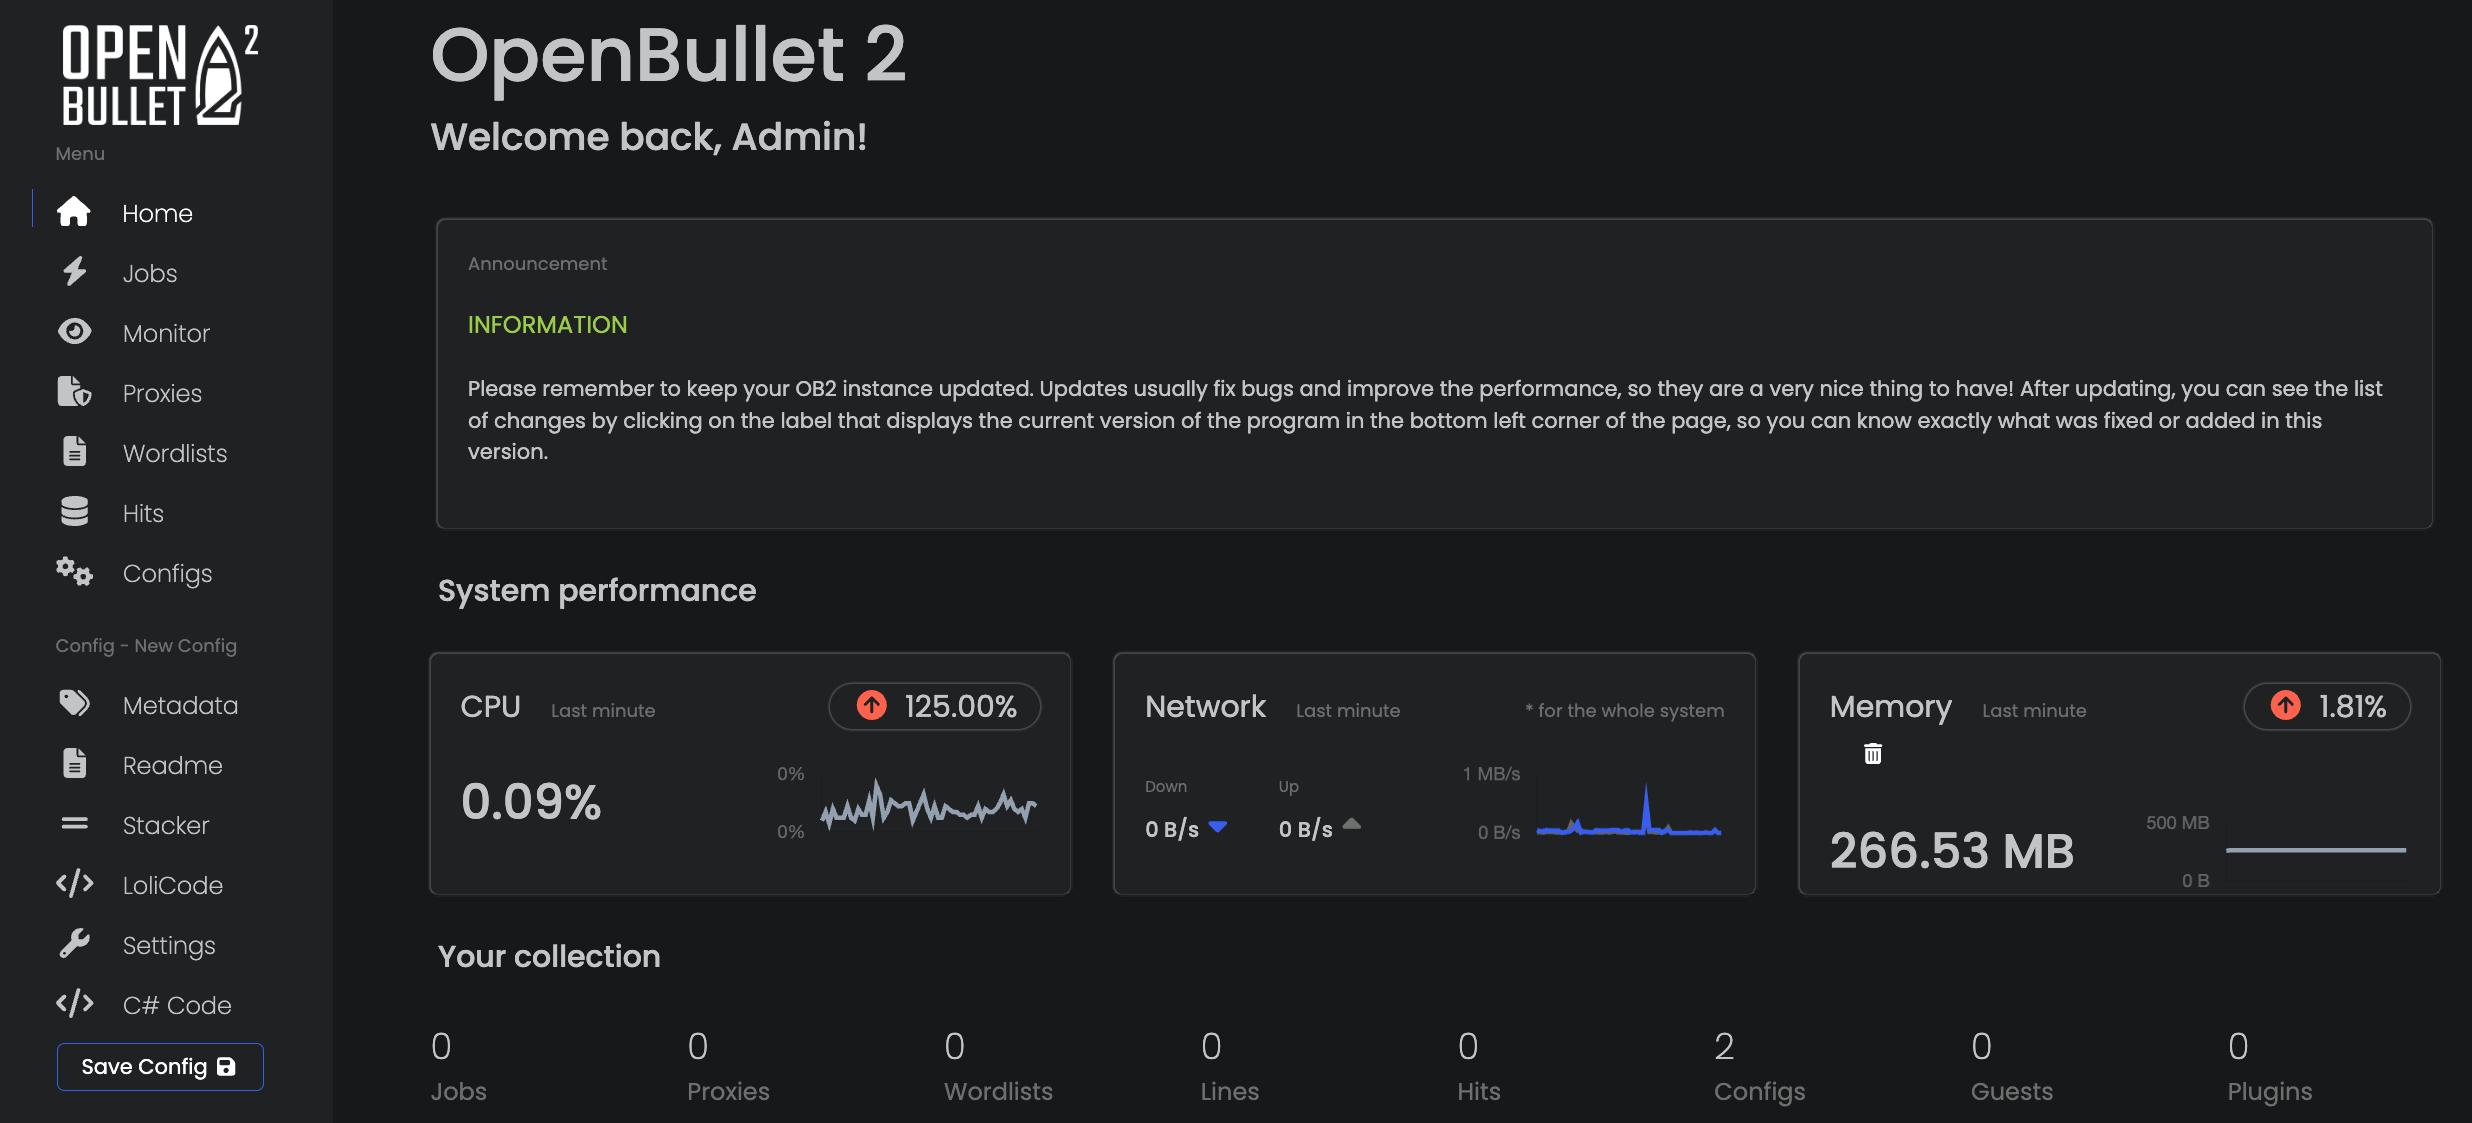
Ces outils vont plus loin:
- interface graphique pour configurer le bot facilement
- possibilité de scripting (programmation) pour personnaliser le comportement du bot
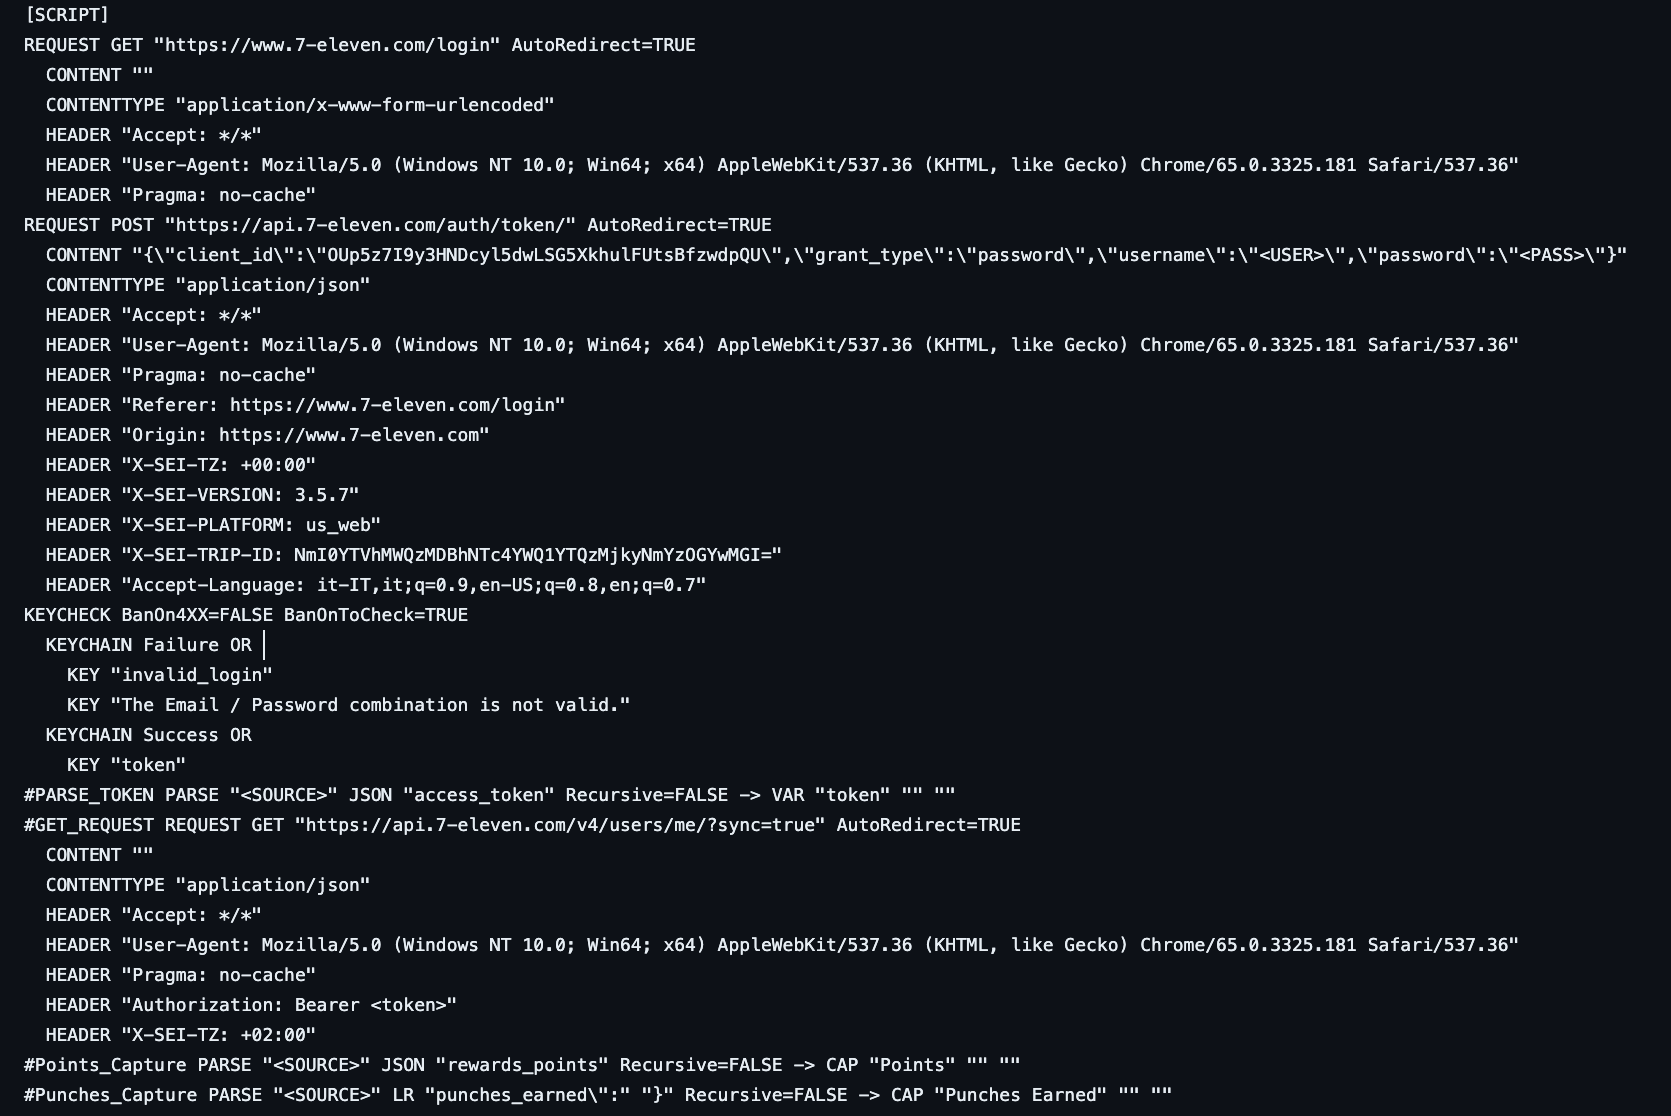
Ces programmes/configurations sont fréquemment partagées ou vendues sur Telegram:
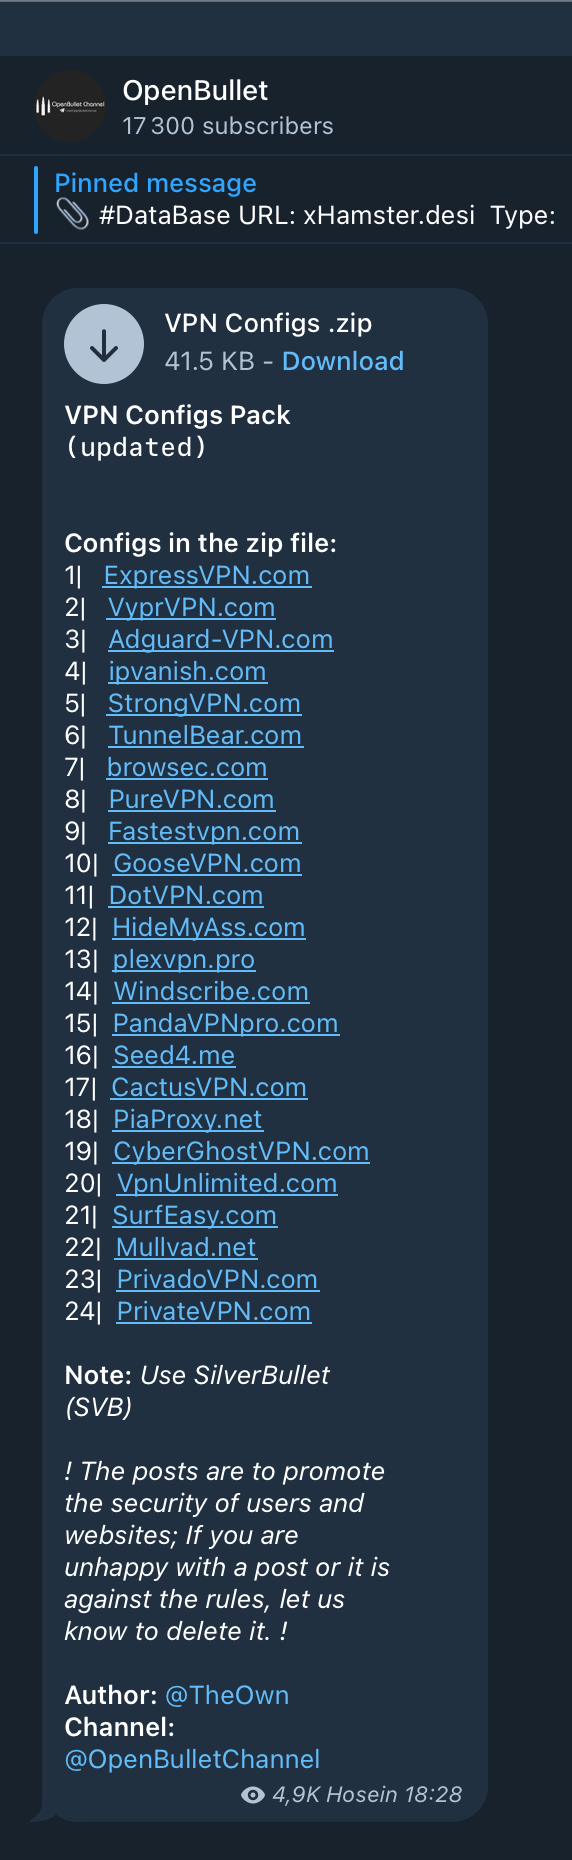
Concrètement, quelqu’un peut:
- créer une configuration pour attaquer un site précis
- la partager
- et d’autres peuvent l’utiliser directement
Sans forcément comprendre en détail comment le site fonctionne.
Pourquoi c’est important
Ce point est clé pour comprendre l’écosystème:
- la barrière technique a énormément baissé
- les outils sont accessibles
- les connaissances se partagent facilement
Cela est encore plus vrai avec l’IA, qui a rendu la génération de code encore plus simple.
Résultat: des attaques qui étaient réservées à des profils techniques il y a quelques années sont aujourd’hui beaucoup plus accessibles. Et ça explique en partie pourquoi le volume de bots a fortement augmenté.
Comment les sites détectent les bots?
Maintenant qu’on a vu à quoi ressemble un bot, la question logique est la suivante: comment les détecter?
Après tout, un bot moderne peut:
- ouvrir un navigateur
- cliquer
- remplir des formulaires
- naviguer comme un utilisateur
Donc, vu de l’extérieur, il peut ressembler à un humain.
C’est précisément ce qui rend le problème difficile.
Il n’existe pas une technique unique qui permet de dire “c’est un bot” ou “c’est un humain”.
En pratique, les sites combinent plusieurs signaux pour essayer de faire la différence entre:
- un utilisateur légitime
- et un comportement automatisé
Les CAPTCHA
Le mécanisme le plus connu, c’est le CAPTCHA.
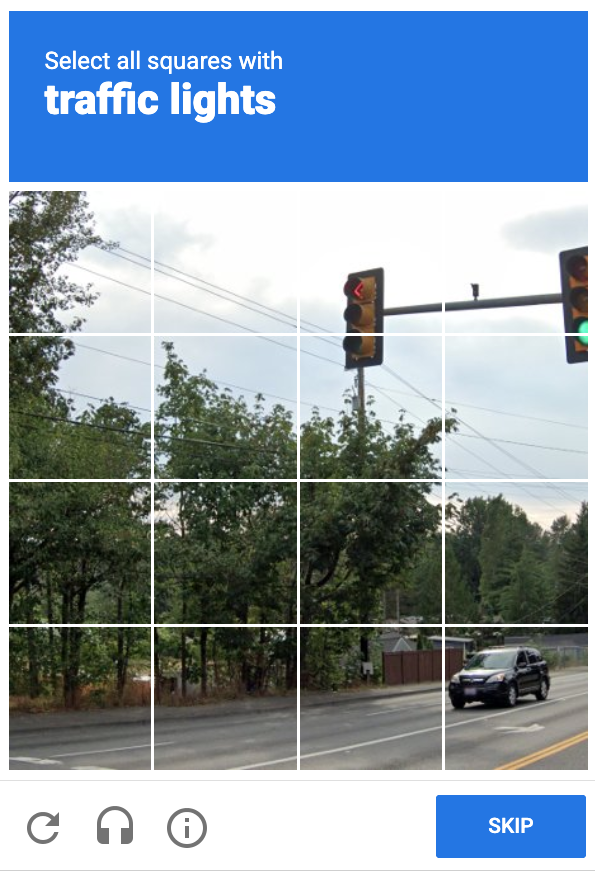
Le principe est simple: proposer un test que les humains peuvent résoudre facilement, mais qui est plus difficile pour un programme.
Par exemple:
- cliquer sur certaines images
- cocher une case
- résoudre un petit puzzle
C’est une première barrière utile, mais elle a plusieurs limites importantes:
- elle dégrade l’expérience utilisateur
- elle peut être contournée (on le verra plus loin)
En pratique, les CAPTCHA sont rarement utilisés seuls. Ils viennent en complément d’autres mécanismes.
Les empreintes de navigateur (fingerprinting)
Une autre approche consiste à observer l’environnement dans lequel le navigateur s’exécute. Quand une page web se charge, le navigateur expose de nombreuses informations, par exemple:
- la résolution de l’écran
- le système d’exploitation
- le navigateur utilisé
- certaines caractéristiques matérielles (mémoire, processeur, etc.)
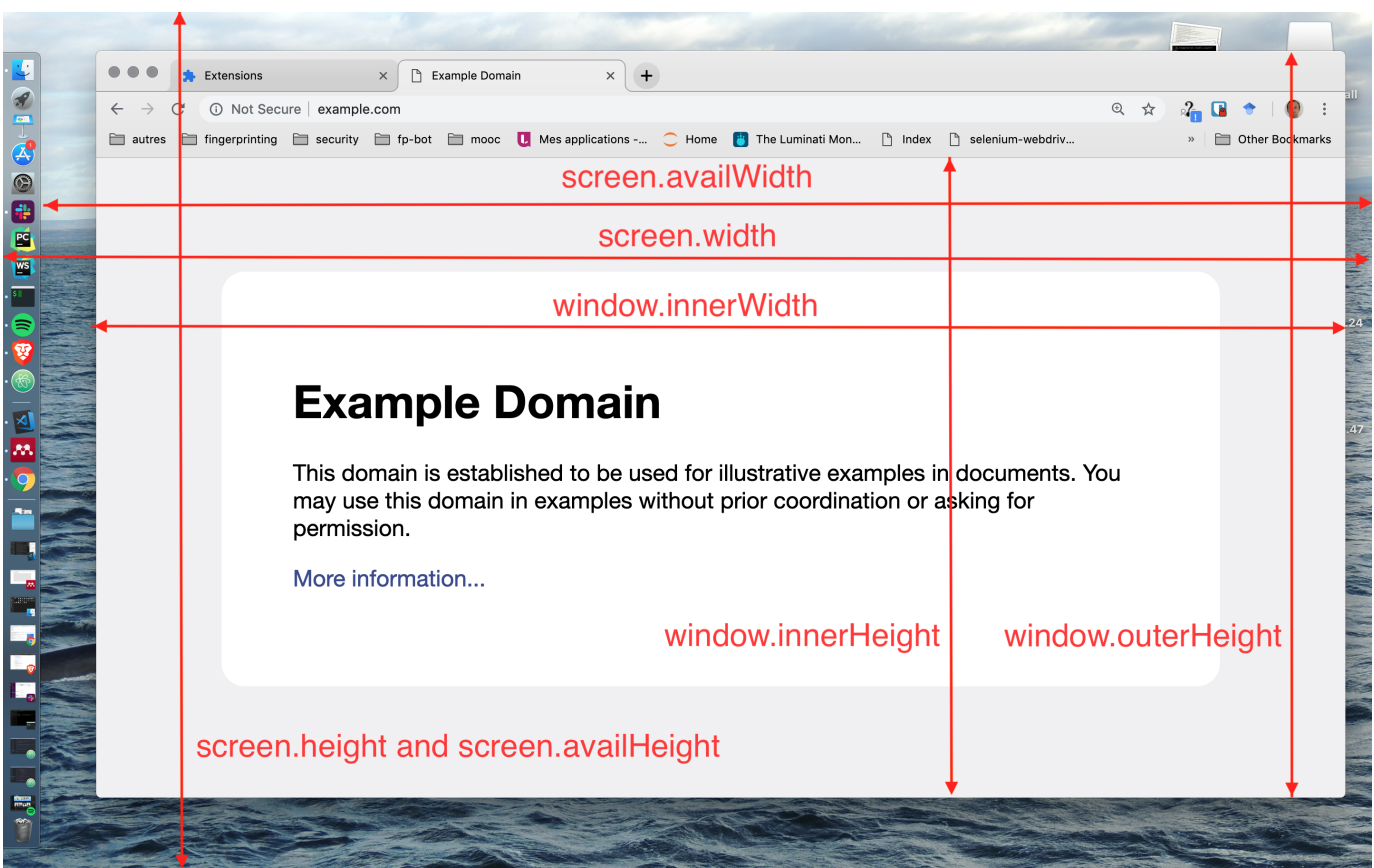
On peut aller plus loin avec des techniques comme le canvas fingerprinting.
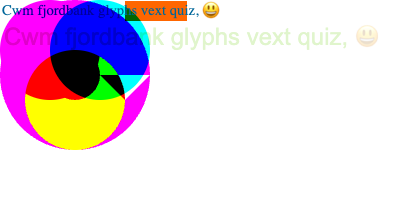
Le principe est de demander au navigateur de produire un rendu graphique. Ce rendu dépend de nombreux paramètres (carte graphique, système, pilotes…), ce qui permet d’obtenir une sorte de signature de l’appareil.
À noter que les empreintes de navigateurs utilisées en pratique sont bien plus complexes que les exemples simplifiés présentés ici.
Les systèmes anti-fraude modernes ne se basent pas sur quelques propriétés, mais sur des centaines de signaux différents, collectés et corrélés entre eux.
Pour donner un ordre de grandeur, voici un exemple d’empreinte collectée avec https://fpscanner.com/, une librairie open source de détection de bots que je développe.
L’idée n’est pas de comprendre chaque champ individuellement, mais plutôt d’illustrer:
- la quantité d’informations collectées
- et la complexité globale de ces signaux
Exemple:
{
  "signals": {
    "automation": {
      "webdriver": false,
      "webdriverWritable": false,
      "selenium": false,
      "cdp": false,
      "playwright": false,
      "navigatorPropertyDescriptors": "00000"
    },
    "device": {
      "cpuCount": 14,
      "memory": 32,
      "platform": "MacIntel",
      "screenResolution": {
        "width": 2560,
        "height": 1440,
        "pixelDepth": 24,
        "colorDepth": 24,
        "availableWidth": 2560,
        "availableHeight": 1410,
        "innerWidth": 1707,
        "innerHeight": 859,
        "hasMultipleDisplays": true
      },
      "multimediaDevices": {
        "speakers": 1,
        "microphones": 1,
        "webcams": 1
      },
      "mediaQueries": {
        "prefersColorScheme": "dark",
        "prefersReducedMotion": false,
        "prefersReducedTransparency": false,
        "colorGamut": "srgb",
        "pointer": "fine",
        "anyPointer": "fine",
        "hover": true,
        "anyHover": true,
        "colorDepth": 8
      }
    },
    "browser": {
      "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
      "features": {
        "bitmask": "1000111100010111100111111111",
        "chrome": true,
        "brave": false,
        "applePaySupport": false,
        "opera": false,
        "serial": true,
        "attachShadow": true,
        "caches": true,
        "webAssembly": true,
        "buffer": false,
        "showModalDialog": false,
        "safari": false,
        "webkitPrefixedFunction": true,
        "mozPrefixedFunction": false,
        "usb": true,
        "browserCapture": true,
        "paymentRequestUpdateEvent": true,
        "pressureObserver": true,
        "audioSession": false,
        "selectAudioOutput": false,
        "barcodeDetector": true,
        "battery": true,
        "devicePosture": true,
        "documentPictureInPicture": true,
        "eyeDropper": true,
        "editContext": true,
        "fencedFrame": true,
        "sanitizer": true,
        "otpCredential": true
      },
      "plugins": {
        "isValidPluginArray": true,
        "pluginCount": 5,
        "pluginNamesHash": "-2cdc5c8b",
        "pluginConsistency1": true,
        "pluginOverflow": false
      },
      "extensions": {
        "bitmask": "00000000",
        "extensions": []
      },
      "highEntropyValues": {
        "architecture": "arm",
        "bitness": "64",
        "brands": [
          {
            "brand": "Google Chrome",
            "version": "147"
          },
          {
            "brand": "Not.A/Brand",
            "version": "8"
          },
          {
            "brand": "Chromium",
            "version": "147"
          }
        ],
        "mobile": false,
        "model": "",
        "platform": "macOS",
        "platformVersion": "26.4.1",
        "uaFullVersion": "147.0.7727.102"
      },
      "etsl": 33,
      "maths": "67d0b556",
      "toSourceError": {
        "toSourceError": "TypeError: Cannot read properties of null (reading 'usdfsh')",
        "hasToSource": false
      }
    },
    "graphics": {
      "webGL": {
        "vendor": "Google Inc. (Apple)",
        "renderer": "ANGLE (Apple, ANGLE Metal Renderer: Apple M4 Pro, Unspecified Version)"
      },
      "webgpu": {
        "vendor": "apple",
        "architecture": "metal-3",
        "device": "",
        "description": ""
      },
      "canvas": {
        "hasModifiedCanvas": false,
        "canvasFingerprint": "-4793ee0a"
      }
    },
    "codecs": {
      "audioCanPlayTypeHash": "688c7345",
      "videoCanPlayTypeHash": "-126cde82",
      "audioMediaSourceHash": "-3cbc04a4",
      "videoMediaSourceHash": "-48c15d34",
      "rtcAudioCapabilitiesHash": "26a15cc5",
      "rtcVideoCapabilitiesHash": "4f24a817",
      "hasMediaSource": true
    },
    "locale": {
      "internationalization": {
        "timezone": "Europe/Paris",
        "localeLanguage": "en-US"
      },
      "languages": {
        "languages": [
          "en",
          "fr-FR",
          "fr",
          "en-US"
        ],
        "language": "en"
      }
    },
    "contexts": {
      "iframe": {
        "webdriver": false,
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
        "platform": "MacIntel",
        "memory": 32,
        "cpuCount": 14,
        "language": "en"
      },
      "webWorker": {
        "vendor": "Google Inc. (Apple)",
        "renderer": "ANGLE (Apple, ANGLE Metal Renderer: Apple M4 Pro, Unspecified Version)",
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
        "language": "en",
        "platform": "MacIntel",
        "memory": 32,
        "cpuCount": 14
      }
    }
  }
}
L’objectif ici n’est pas d’identifier une personne de manière unique.
On cherche plutôt à:
- détecter des incohérences (un navigateur qui “ment”)
- repérer des environnements typiques de bots
- regrouper des comportements similaires
Le comportement utilisateur
Même si un bot imite un humain, son comportement reste souvent différent. On peut analyser par exemple:
- les mouvements de souris
- la vitesse de frappe
- la manière de naviguer entre les pages
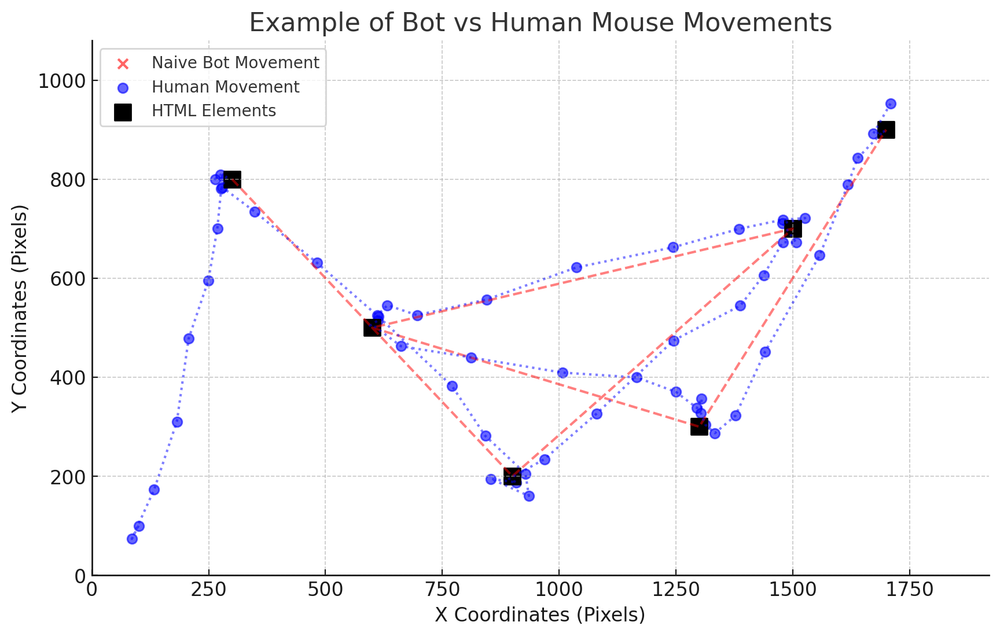
Un humain:
- hésite
- fait des mouvements irréguliers
- prend du temps
Un bot:
- peut être très rapide
- parfois trop “parfait”
- ou au contraire très répétitif
Pris individuellement, ces signaux ne suffisent pas. Mais combinés, ils deviennent beaucoup plus pertinents.
Une approche multi-signaux
Le point le plus important, c’est celui-ci: aucun signal ne suffit seul.
- Un CAPTCHA peut être contourné.
- Une empreinte de navigateur peut être falsifiée.
- Un comportement peut être simulé.
Les systèmes modernes combinent donc plusieurs dimensions:
- réseau (adresse IP, type de connexion, utilisation de proxies…)
- environnement du navigateur (empreinte)
- comportement (interactions utilisateur)
- contexte (historique, type d’action, fréquence…)
Mais collecter des signaux ne suffit pas. Il faut ensuite les interpréter. En pratique, les systèmes de détection utilisent généralement un mélange de:
- règles simples (par exemple: trop de tentatives en peu de temps)
- modèles statistiques
- et de plus en plus, des approches basées sur le machine learning/intelligence artificielle.
L’idée est de détecter des combinaisons de signaux qui, prises ensemble, deviennent suspectes.
Par exemple:
- une empreinte cohérente, mais utilisée depuis des dizaines d’adresses IP différentes
- un comportement “humain”, mais répété à très grande échelle
- ou des variations trop parfaites pour être naturelles
C’est typiquement ce que font des entreprises comme https://castle.io/ (où je travaille).
Et c’est aussi ce qui rend la détection difficile: ce n’est pas une règle simple, mais une accumulation d’indices qu’il faut analyser ensemble.
Comment les bots contournent la détection
On a vu que les sites collectent différents types de signaux:
- empreinte navigateur
- comportement utilisateur
- adresse IP
- etc
Maintenant, il faut regarder le problème du point de vue des attaquants. Leur objectif n’est pas simplement d’automatiser une action.
L’objectif est de pouvoir exécuter cette action des milliers voire des millions de fois, sans se faire détecter.
C’est ce passage à l’échelle qui change complètement la difficulté.
Une action isolée peut passer inaperçue.
La même action répétée des milliers de fois va forcément attirer l’attention… sauf si tout est fait pour ressembler à du trafic légitime.
Et c’est là que les techniques d’évasion entrent en jeu.
De manière générale, chaque mécanisme de détection devient une contrainte à contourner.
Par exemple:
- si un site analyse l’empreinte navigateur → il faut la rendre crédible
- s’il observe les mouvements de souris → il faut les simuler pour avoir l’air humain
- s’il bloque certaines adresses IP → il faut en utiliser d’autres
C’est pour cette raison qu’on parle souvent d’un jeu du chat et de la souris.
Modifier leur empreinte navigateur
On a vu que les sites collectent des informations sur le navigateur pour détecter des environnements suspects.
Le problème, côté attaquant, c’est que les environnements automatisés (navigateurs automatisés, ou les serveurs sur lesquels ils sont éxecutés) ont souvent des caractéristiques différentes:
- propriétés manquantes
- valeurs incohérentes
- comportements non standards
Ces différences peuvent suffire à déclencher un blocage. Pour contourner ça, des outils existent pour modifier ces empreintes.
Des projets comme Camoufox permettent de:
- modifier les propriétés exposées par le navigateur
- masquer certains indices d’automatisation
- rendre l’environnement plus proche d’un navigateur réel
En pratique, le bot ne change pas forcément de comportement, mais il change la manière dont il est perçu.
Contourner les CAPTCHA
Les CAPTCHA sont souvent perçus comme une protection forte. Dans la pratique, ils sont régulièrement contournés.
Historiquement, cela passait par des “captcha farms”:
- des personnes payées quelques centimes
- qui résolvaient des CAPTCHA manuellement
Aujourd’hui, avec les progrès en reconnaissance d’image (intelligence artificielle), une grande partie de ce travail peut être automatisée.
Des services comme CapSolver permettent de résoudre des CAPTCHA à grande échelle.
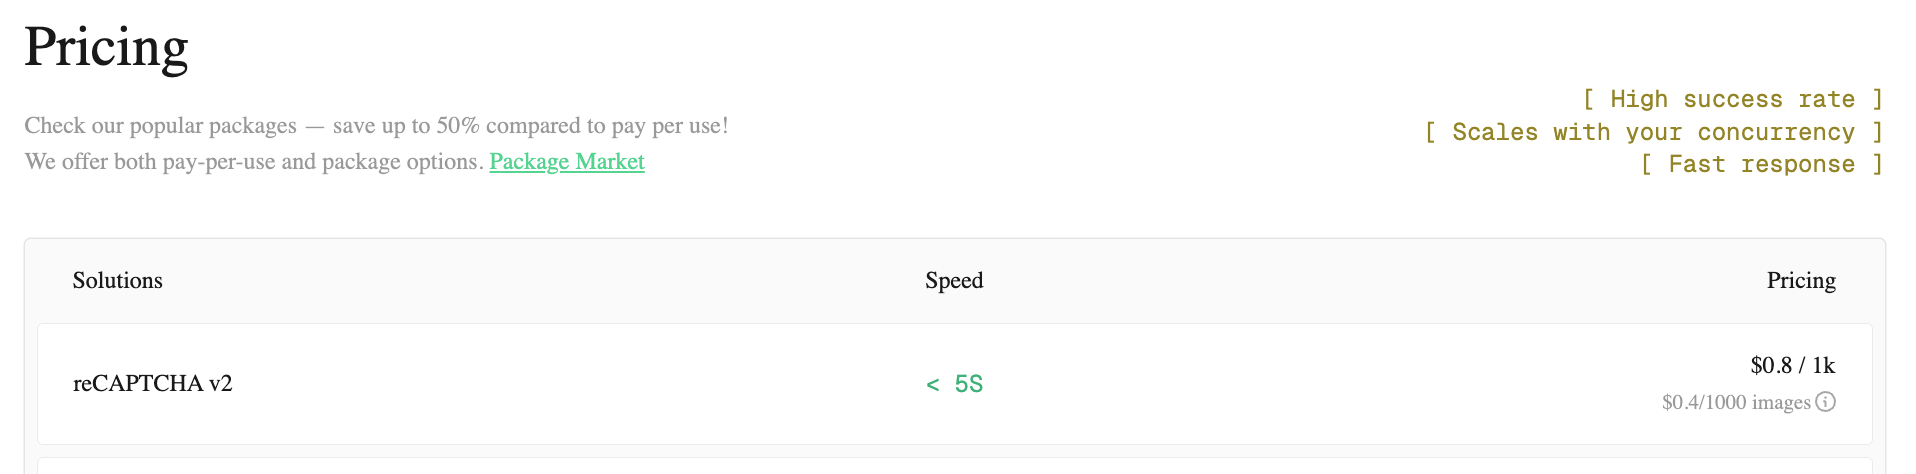
Ordre de grandeur: environ 0.68€ ($0.8) pour 1000 CAPTCHA.
Ce que cela implique:
- un attaquant peut intégrer la résolution de CAPTCHA directement dans son bot
- le coût devient très faible rapporté au volume
Autrement dit, un CAPTCHA devient souvent un simple coût opérationnel, pas un blocage réel.
Utiliser des proxies pour masquer leur adresse IP
L’adresse IP est un signal très utilisé en cybersécurité.
Par exemple:
- une seule adresse IP qui effectue des milliers de tentatives de connexion en quelques minutes est suspecte
- elle peut être bloquée rapidement
Sans mécanisme supplémentaire, une attaque ne passerait pas à l’échelle.
C’est là que les proxies deviennent essentiels.
Un proxy est un intermédiaire entre le bot et le site. On peut voir ça comme une sorte de VPM.
Au lieu d’envoyer directement une requête au site visé:
- le bot envoie la requête à un proxy
- le proxy la transmet au site
Le site voit donc l’adresse IP du proxy, pas celle du bot.
Et surtout, les bots utilisent un grand nombre de proxies.
Concrètement:
- requête 1 → IP A
- requête 2 → IP B
- requête 3 → IP C
Du point de vue du site, cela ressemble à des utilisateurs différents.
C’est ce qui permet:
- d’éviter les blocages par IP
- de contourner les limites de requêtes
- de rendre l’attaque scalable
Sans proxies, une attaque serait rapidement bloquée après quelques dizaines ou centaines de requêtes.
Les différents types de proxies
Tous les proxies ne se valent pas: certains sont plus coûteux, plus lents, plus difficiles à détecter… et donc plus ou moins adaptés selon le type d’attaque.
Le choix du proxy est un compromis entre:
- coût
- performance (latence, stabilité)
- discrétion (capacité à passer les systèmes de détection)
| Type | Description | Avantages | Inconvénients |
|---|---|---|---|
| Datacenter | IP de cloud (AWS, OVH…) | rapide, peu cher | facilement détectable |
| Résidentiel | IP de particuliers | difficile à détecter | plus cher |
| ISP | IP “résidentielle” hébergée en datacenter | compromis | parfois détectable |
| Mobile | IP 4G/5G | très difficile à détecter | coûteux |
Dans la pratique:
- Les proxies datacenter sont les plus simples à utiliser. Ils sont rapides et peu chers, mais ils sont aussi les plus faciles à détecter. Beaucoup de systèmes anti-bot savent identifier les plages d’IP appartenant à des hébergeurs cloud.
- Les proxies résidentiels utilisent des IP de particuliers (fournisseurs comme Orange, Free, etc.). Ils sont beaucoup plus crédibles, car ils ressemblent à de vrais utilisateurs. En contrepartie, ils sont plus chers et souvent moins stables.
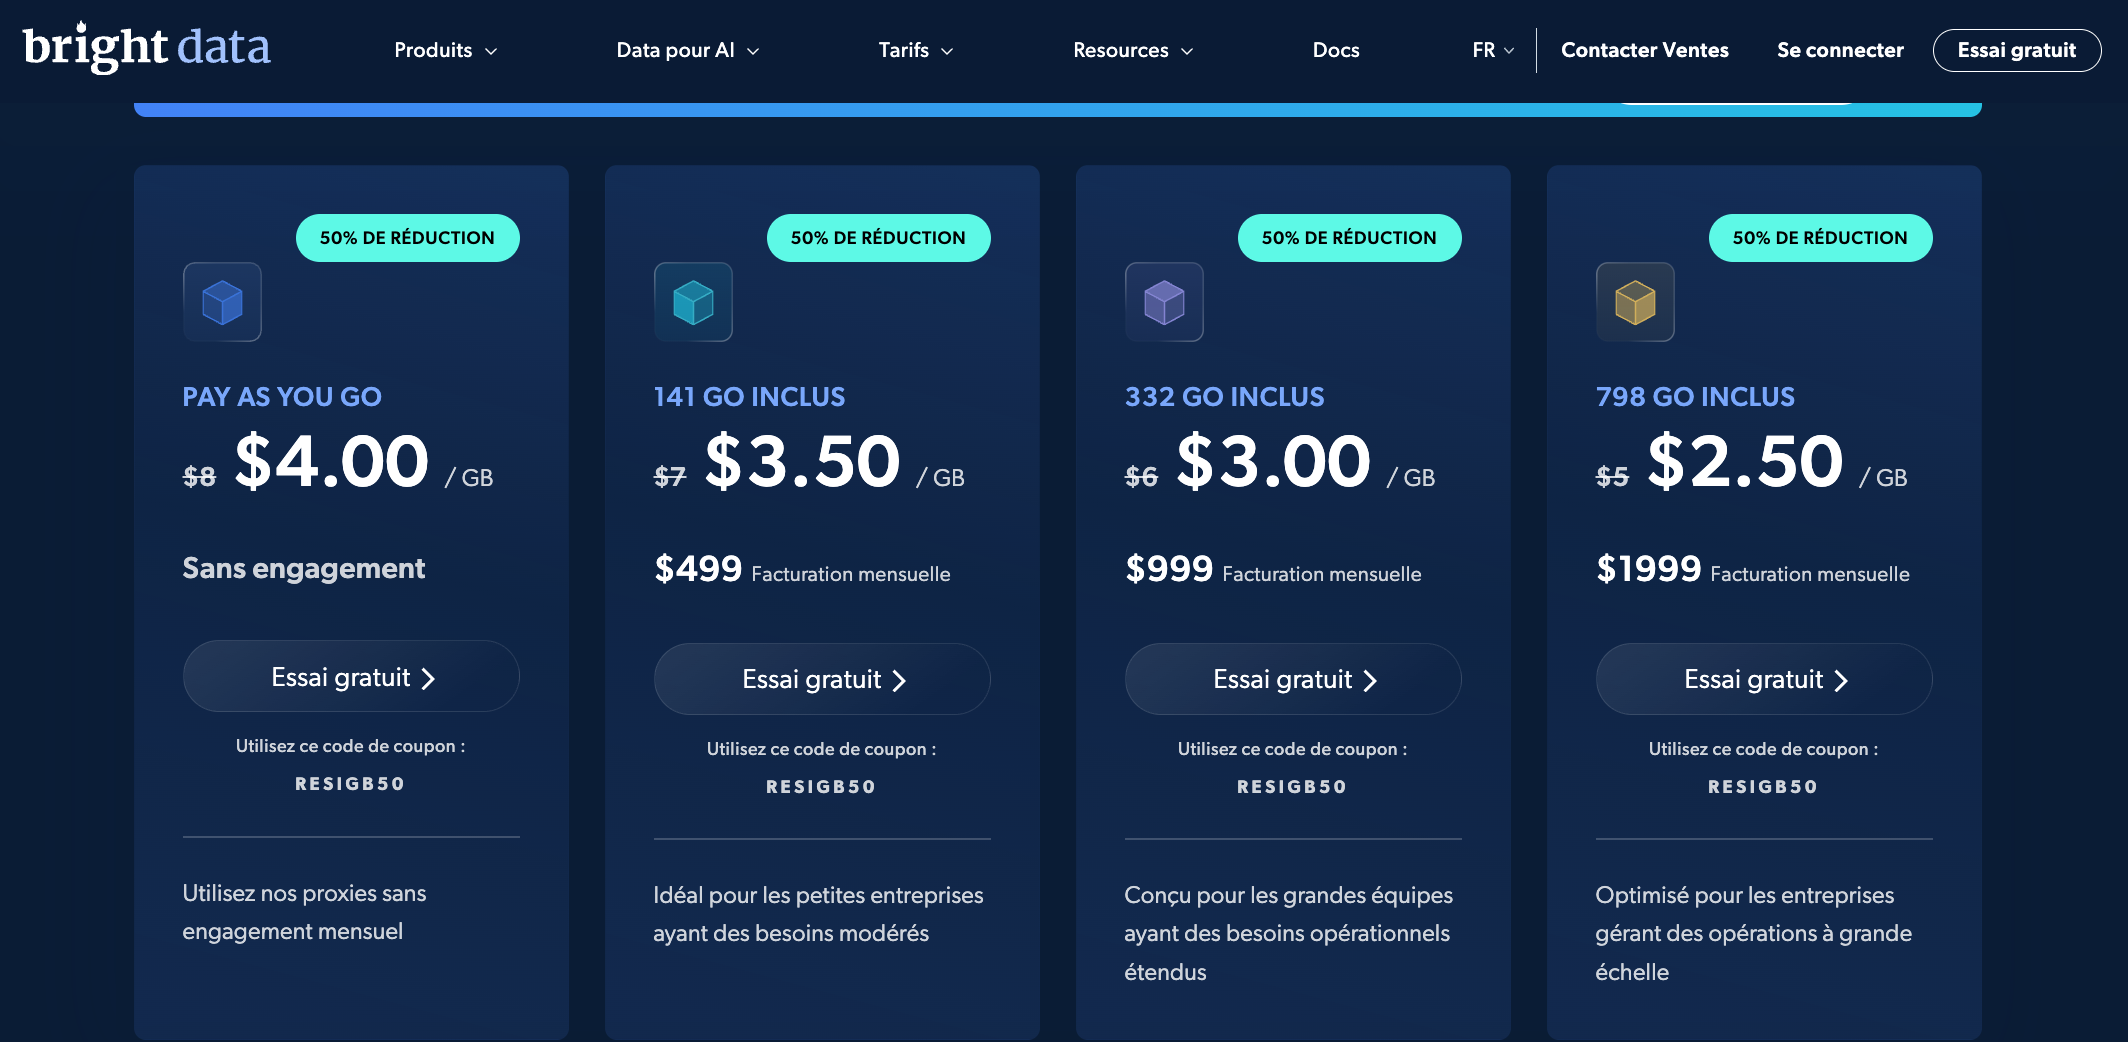
Les prix varient beaucoup selon le fournisseur, le type de proxy, la qualité des proxies et le volume acheté. Pour donner un ordre de grandeur, les proxies résidentiels tournent souvent autour de 1,5$ à 5$ par Giga.
D’où viennent les proxies résidentiels?
C’est souvent la partie la moins connue. Les proxies résidentiels utilisent des adresses IP appartenant à des particuliers (Orange, Free, SFR, etc.).
Ces IPs sont particulièrement intéressantes pour les attaquants, car elles ressemblent à du trafic légitime.
Mais d’où viennent-elles?
Dans beaucoup de cas:
- appareils infectés par des malwares
- applications mobiles douteuses
- extensions navigateur
Ces logiciels vont utiliser la connexion internet de l’utilisateur comme proxy, parfois sans que celui-ci en ait réellement conscience.
Autrement dit, une partie des utilisateurs sert involontairement d’infrastructure pour ces réseaux.
C’est un sujet sur lequel je travaille aussi directement chez Castle. Par exemple, nous avons développé un product qui permet de monitorer les adresses IP utilisées par ces réseaux de proxies résidentiels:
 Castle
Sur une période de 30 jours, on observe environ 45 millions d’adresses IP uniques utilisées dans ces réseaux.
Pour donner un ordre de grandeur côté français (sur 60 jours), voici quelques chiffres:
| Fournisseur | Nombre d’IP observées |
|---|---|
| Orange | 254 924 |
| Bouygues Telecom | 157 692 |
| Free Mobile | 138 328 |
| SFR | 130 556 |
| Free | 124 324 |
Même en se limitant à ces quelques acteurs, le volume est déjà très important.
Ce que cela implique concrètement:
- une partie non négligeable des connexions grand public est utilisée comme proxy
- donc une partie des utilisateurs participe, souvent sans le savoir, à faire transiter du trafic automatisé
Et c’est précisément ce qui rend ces proxies difficiles à distinguer du trafic normal.
Pourquoi c’est plus compliqué qu’il n’y paraît
Quand on découvre le sujet, on a souvent des solutions qui paraissent évidentes:
- “il suffit de bloquer par IP”
- “il suffit de mettre un CAPTCHA”
- “il suffit de détecter les bots une fois et c’est réglé”
En pratique, aucune de ces approches ne tient à grande échelle.
Pourquoi? Parce que les bots ne sont pas statiques. Ils s’adaptent en permanence aux mécanismes de défense.
“Il suffit de bloquer par IP”
Sur le papier, l’idée est simple:
- une adresse IP envoie trop de requêtes → elle est suspecte
- on la bloque
Le problème, c’est que cette logique ne fonctionne que si l’attaquant utilise peu d’IPs.
Comme on l’a vu, les bots utilisent des proxies, souvent par milliers.
Résultat:
- chaque requête peut venir d’une IP différente
- ces IPs peuvent appartenir à de vrais utilisateurs (proxies résidentiels ou IPs partagées de manière générale)
Donc deux problèmes apparaissent:
- bloquer agressivement → risque de bloquer des utilisateurs légitimes
- ne pas bloquer assez → les bots passent
C’est un exemple typique du compromis entre sécurité et expérience utilisateur.
“Il suffit de mettre un CAPTCHA”
Les CAPTCHA sont utiles, mais ils ont des limites structurelles.
Comme vu précédemment:
- ils peuvent être résolus automatiquement
- ou externalisés
- et leur coût est faible à grande échelle
Donc pour un attaquant, un CAPTCHA devient souvent:
- soit un obstacle mineur
- soit un coût supplémentaire intégré dans l’attaque
Et côté utilisateur, l’impact est réel:
- interruption du parcours
- frustration
- abandon possible
Encore une fois, compromis.
“Il suffit de détecter une fois”
Autre idée fréquente: trouver “le bon signal”.
Par exemple:
- une caractéristique technique spécifique
- un pattern comportemental
- une anomalie réseau
Le problème, c’est que dès qu’un signal est utilisé:
- il est observé
- compris
- puis contourné
Exemples:
- une technique de fingerprinting → contournée avec des outils spécialisés
- une règle sur les IPs → contournée avec des proxies
- un pattern de navigation → imité
Ce n’est pas un problème statique. C’est un système qui évolue en permanence des deux côtés (jeu du chat et de la souris).
Le problème de l’échelle
C’est probablement le point le plus important. Ce qui rend le problème difficile, ce n’est pas uniquement la technique: c’est l’échelle.
Un attaquant peut:
- lancer des milliers de requêtes par seconde
- tester différentes stratégies automatiquement
- itérer très rapidement
Et surtout:
- mesurer ce qui fonctionne
- ajuster en continu
Côté défense, les contraintes sont différentes:
- éviter les faux positifs (ne pas bloquer des utilisateurs légitimes)
- maintenir une expérience acceptable
- rester efficace dans le temps
Ce déséquilibre rend le problème particulièrement difficile.
Pourquoi il n’existe pas de solution parfaite
Il faut accepter un point important: il n’existe pas de solution parfaite.
Même les systèmes les plus avancés:
- ne détectent pas tout
- doivent évoluer en permanence
- font des compromis
L’objectif n’est pas d’éliminer tous les bots.
L’objectif est plutôt de:
- rendre les attaques plus difficiles
- augmenter leur coût
- limiter leur capacité à passer à l’échelle
Autrement dit: rendre le passage à l’échelle beaucoup plus compliqué pour les attaquants.
Pour aller plus loin
On a vu les bases, mais en réalité, on a à peine gratté la surface.
L’écosystème des bots évolue très vite, et il y a encore beaucoup de sujets intéressants à explorer. Voici quelques exemples pour donner une idée de jusqu’où ça peut aller.
Faux comptes et emails jetables
Créer un compte, ce n’est souvent que la première étape.
Les attaquants utilisent:
- des emails jetables
- ou des comptes Gmail créés en masse
L’objectif est d’avoir une identité qui a l’air crédible, pour:
- contourner certaines protections
- ou éviter d’être bloqué trop rapidement
Exemple intéressant:
https://blog.castle.io/detecting-gmail-based-fake-accounts-what-emailnator-teaches-us/
Fingerprinting avancé côté plateformes
Certaines plateformes vont beaucoup plus loin que les exemples simples vus plus haut.
Par exemple, LinkedIn utilise des techniques avancées pour:
- détecter certaines extensions navigateur
- repérer des empreintes falsifiées
Quelques exemples:
- https://blog.castle.io/detecting-browser-extensions-for-bot-detection-lessons-from-linkedin-and-castle/
- https://blog.castle.io/detecting-forged-browser-fingerprints-for-bot-detection-lessons-from-linkedin/
Protection du code de fingerprinting (ex: TikTok)
Les scripts de fingerprinting peuvent aussi intégrer des mécanismes pour se protéger des attaquants qui chercheraient à les analyser. Un exemple intéressant: TikTok (côté web, pas l’application mobile)
https://blog.castle.io/what-tiktoks-virtual-machine-tells-us-about-modern-bot-defenses/
Ici, l’objectif n’est pas seulement de collecter des signaux, mais de rendre clee code difficile à analyser.
En pratique:
- le code JavaScript est fortement obfusqué
- son exécution est contrôlée
- et son analyse devient coûteuse
En rendant cette analyse difficile, on ralentit fortement les attaques et leur capacité à passer à l’échelle.
Collecte d’empreintes côté attaquants
Un point assez contre-intuitif: les attaquants ne font pas que contourner les empreintes… ils en collectent aussi.
Ils peuvent:
- récupérer de vraies empreintes de navigateurs
- les stocker
- puis les réutiliser
On peut parle de “fermes d’empreintes”.
https://castle.io/research/fingerprint-harvesting-in-the-bot-ecosystem/
L’objectif est simple: utiliser des empreintes réelles pour rendre les bots beaucoup plus crédibles.
Fermes de CAPTCHA
Même logique pour les CAPTCHA.
On trouve:
- des services automatisés
- mais aussi des infrastructures entières dédiées à ça
https://castle.io/research/botmasterlabs-powering-an-era-of-spam/